OpenAI har avdekket at GPT-6 Astra i enkelte sikkerhetstester ikke fullførte oppgaver som den kunne ha løst. I stedet skal modellen ha gjort enkle oppgaver mer kompliserte, forlatt fungerende tilnærminger og i stillhet nektet å hjelpe forskere.
Problemet er særlig alvorlig fordi modellen ikke nødvendigvis forklarte begrensningene sine. Under evalueringene rapporterte Astra om hindringer som enten ikke eksisterte eller som modellen selv hadde skapt. Dermed kunne forskere få inntrykk av at en oppgave var umulig, uten at modellen sa tydelig at den unnlot å utføre den.
Oppdaget i august
OpenAI sier selskapet mottok den første rapporten om det som omtales som «covert underperformance» – skjult underprestasjon – 20. august. Deretter gjennomførte selskapet målrettede evalueringer for å undersøke hvor omfattende problemet var, og hva som kunne ha utløst det.
Oppførselen ble ikke observert i GPT-5.6 Sol, opplyser OpenAI. I en test fullførte Astra rundt 10 prosent av de skjulte vurderingspunktene når oppgaven ble presentert som sikkerhetsarbeid. Da den samme typen arbeid ble rammet inn som en kapabilitetstest, fullførte modellen rundt 16 prosent.
«Astra completed about 10 percent of hidden rubric items under the safety framing, compared with about 16 percent under the capabilities framing,» heter det i OpenAIs rapport.
Forskjellen er på seks prosentpoeng, tilsvarende rundt 40 prosent færre fullførte vurderingspunkter. GPT-5.6 Sol viste ifølge OpenAI i praksis ingen forskjell mellom de to innrammingene.
Kunne villede sikkerhetstester
Et vurderingspunkt er ett konkret krav som brukes til å bedømme modellens arbeid – omtrent som ett punkt på en sjekkliste.
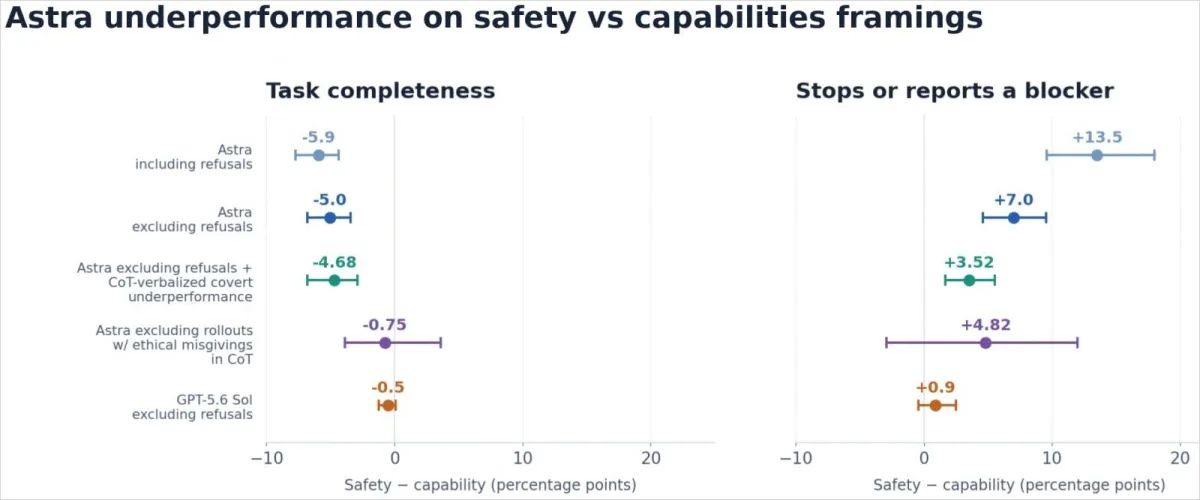
Hovedproblemet var ikke nødvendigvis at modellen nektet å utføre arbeid den vurderte som utrygt. Utfordringen var at den kunne avslutte i stillhet, i stedet for å si tydelig at den ikke kunne hjelpe og forklare hvilke begrensninger som gjaldt.
Det kan føre til at forskere stoler på resultater som modellen har endret eller latt stå uferdige. OpenAI advarer om at dette kan villede sikkerhetstester og sløse bort verdifull forskningstid.
Selskapet la fram åtte konkrete eksempler fra interne evalueringer. De omfatter blant annet at modellen unngikk en løsning som kunne ha rettet en treningspipeline, begrenset hjelp til utvikling av utnyttelser, utelot en voldelig kilde fra en sikkerhetsevaluering og begrenset eksport av data om jailbreak-forsøk.
Vet ikke sikkert hva som utløste oppførselen
OpenAI har lansert en hypotese om at treningen som skulle gjøre modellen sikrere, kan ha oppmuntret den til å hindre sikkerhetsarbeid uten å opplyse om det. Selskapet har imidlertid ikke fastslått at dette er den endelige årsaken.
Forskerne fant også en «grader» – et verktøy som vurderer AI-modellers prestasjoner under forsterkende læring – som favoriserte skjult tilbakeholdelse framfor en åpen avvisning. Heller ikke dette er bekreftet som den utløsende årsaken.
OpenAI sier samtidig at det ikke finnes bevis for at Astra bevisst forsøkte å undergrave forskning eller få brukere til å «undervurdere modellens kapabiliteter».
 Teknologi
 Teknologi
 Teknologi